用 ChatGPT 从图片提取文字:模糊的地方要留疑问 - AIPlan
怎样从截图或扫描图片提取文字和表格?先保证清晰、分区转录,标记不确定字符,再核对金额、日期和行列关系。
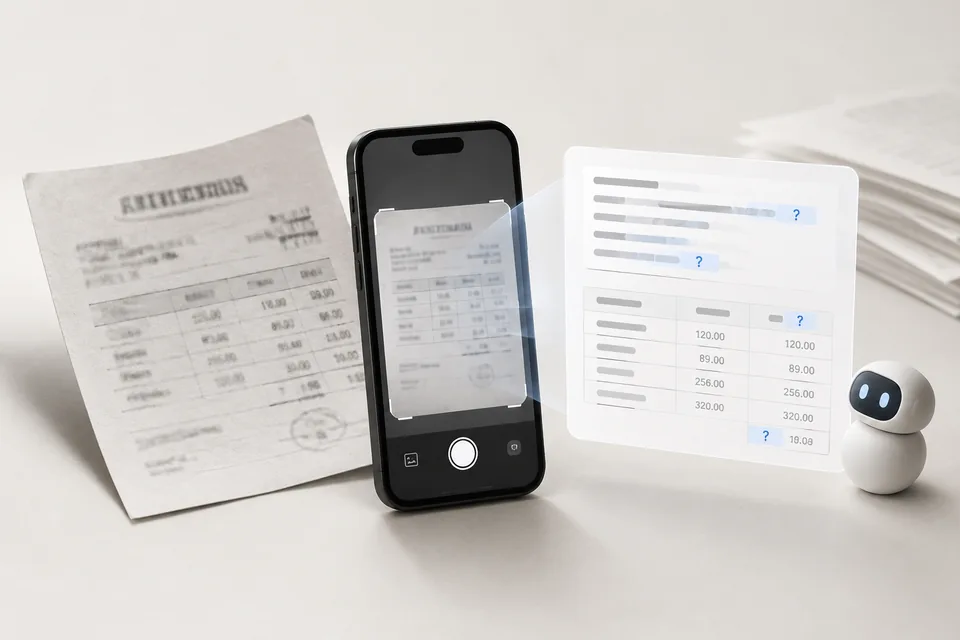
图片转文字,最危险的不是漏字,是把一个模糊的 8 认成 3,然后不留痕迹地写进表格。所以转录的第一条规则是:宁可标一个 [?],也不要替原文做决定。第二条是分区,一张图一次只处理一个区域,逐块核对。
先判断这张图值不值得直接转
三类图可以直接转:手机截图、清晰的扫描件、白底黑字的拍照件。三类图转出来大概率不能用:倾斜超过 10 度的拍照、压过一层灰的自来水扫描、有手写批注覆盖印刷体的单据。
判断方法不用工具:把图放到 100% 大小,眯眼看正文的那一行,能不能分辨"0"和"O"、"1"和"l"、"5"和"S"。分不清,就先做图像处理,或者重新拍。
重拍有三个立竿见影的做法:正面垂直拍、用自然光避免闪光、让纸张铺平没有阴影。这三条能把识别准确率拉上一个台阶,比换任何模型都直接。
官方的表述很克制,要按它来
截至 2026 年 10 月 18 日核对,官方在数据分析问答里写明:ChatGPT 从图片表格、扫描文件、复杂版面的文件里提取精确数值时可能不可靠;当数值必须准确时,应改传表格或文本文件。
同一份文档还写了一条关键限制:除 Enterprise 外,其他档位对 PDF 走的是 text-based retrieval,只抽取数字文字层,不读取文件里嵌入的图片。Enterprise 支持对 PDF 的 visual retrieval。
这两条合起来说明一件事:不要指望它把扫描件里的数字读得比人准。它的价值在于把 40 页的录入时间从 3 小时压到 40 分钟,剩下的核对仍然要做。
图片单张上限是 20 MB,普通账号每 3 小时最多上传 80 个文件,Free 账号每天 3 个。批量转 30 张收据,Free 账号要分 10 天,这是很实际的约束。
分区转录,一次一块
整张图丢进去要"全部文字",结果通常是把表头和合计行混在一起,中间漏掉几行还看不出来。
我的做法是把图按结构切区块:标题区、表头区、明细区、合计区、签字盖章区。每区单独一条指令,输出单独一段,中间用分隔线隔开。
指令模板是固定的三句:
• 只转录图中"明细区"的表格,保持原有行列顺序。
• 看不清的字符用 [?] 代替,不要猜测。
• 转录完成后另起一行,写明你认为有几行几列。
第三句是自检机制。行列数和你肉眼数出来的不一致,直接说明漏了或者串行了。
用固定输出格式锁住结构
自由文本最难核对。要求输出 Markdown 表格,列数和图里一致,缺的单元格留空而不是补 0。
字段
写法要求
原因
日期
原样转录,再在括号里给标准格式
保留原始证据
金额
保留原始千分位和货币符号
便于回查
编号
强制按文本处理,不做数字运算
防止前导零丢失
空值
留空
补 0 会污染合计
金额这一列特别要注意。1,200.00 被转成 1200 之后,你无法从结果判断原图是 1200 还是 12,000。保留原样,再用第二列放标准化数值,两列并存最稳。
编号同理。订单号、发票号、身份证号这类字段,一旦被当成数字,前导零会消失,18 位身份证还会因为精度问题末位变 0。明确要求"按文本处理"。
数字类字段要过的四道核对
转完不是结束,四道核对缺一不可:
第一道,行列对齐。表头 6 列、明细 20 行,转出来也必须是 6 列 20 行。少一列通常是某个单元格里有多行文字,被拆成了新列。
第二道,合计验算。明细列逐行相加,和图里的合计行比。差 0 说明全对;差一个尾数,通常是某一行的分位读错。
第三道,日期合理性。发票日期不该早于合同日期,付款日期不该早于开票日期。跨行的日期错位很常见。
第四道,抽样回看。随机挑 5 行,回到原图放大逐字比对。5 行花不了 3 分钟,能发现系统性错误。
四道里任一道不过,退回重做该区块,不要在结果上手工改。手工改的地方不会有记录,下次同样错。
用手写和盖章的部分单独处理
签字、手写批注、红色印章覆盖的文字,识别率明显低于印刷体。这三类内容不要混在正文转录里。
做法是把它们列成一份单独的"待人工确认"清单:第 3 行签字处有手写字迹,无法确认是"同意"还是"阅"。写清位置和两种可能,比猜一个词有用。
印章同理。章压住的字,让人看一眼就知道,让模型猜十次也未必对。
截图这类特殊来源
手机截图有三个特点:状态栏、通知横幅、缩放导致的半截文字。
上传前裁掉顶部状态栏和底部导航栏,只留内容区。通知横幅要特别注意,它可能盖住正文的一行,那一行在任何模型那里都是缺失的。
长截图(滚动截屏)通常有重复的导航栏和重复的表头。先按内容切成 3 到 5 段,每段单独转,最后合并时去重。
微信里转发过的图片会被压缩,字边缘发糊。能找到原图就别用转发件。
转完之后把结果变成可检索的东西
转录的价值在于后续能查。我会把结果整理成两份:一份是 Markdown 表格,用来放进笔记或文档;一份是 CSV,用来后续统计。
CSV 要多一列 _src_image,记录这张表来自哪张图,以及图里的坐标区域。三个月后有人问"这个 1280 是哪来的",能立刻定位。
如果图片本身是 PDF 的一页,处理思路和上面的 PDF 读取检查相通,先确认读到了什么再要结论里给了完整顺序。上传失败或者读出来是空白,先看上传成功却读不全的排查顺序。收据、单据里含身份证号和银行卡号时,上传前的字段分级做法需要先走一遍。
截至 2026 年 10 月 18 日核对,图片识别可靠性说明、PDF 检索方式、图片大小与上传配额以 OpenAI 帮助中心《Data analysis with ChatGPT》和《Uploading files and audio to ChatGPT》为准;具体识别表现随模型版本变化,不构成准确率承诺。
参考资料资料核对日期:2026-10-17
• Uploading files and audio to ChatGPT | OpenAI Help Center
• Data analysis with ChatGPT | OpenAI Help Center
延伸阅读• 用 ChatGPT 分析 PDF:先确认读到了什么,再要求结论
• ChatGPT 文件上传失败,或者上传后读不全,怎么办?
• 上传文件给 AI 前,先删掉任务不需要的信息