上传文件给 AI 前,先删掉任务不需要的信息 - AIPlan
上传客户表格、合同或学习资料前,怎样做最小化与去标识化?提供字段分级、替代编号和本地映射方法,说明权限与数据控制的区别。
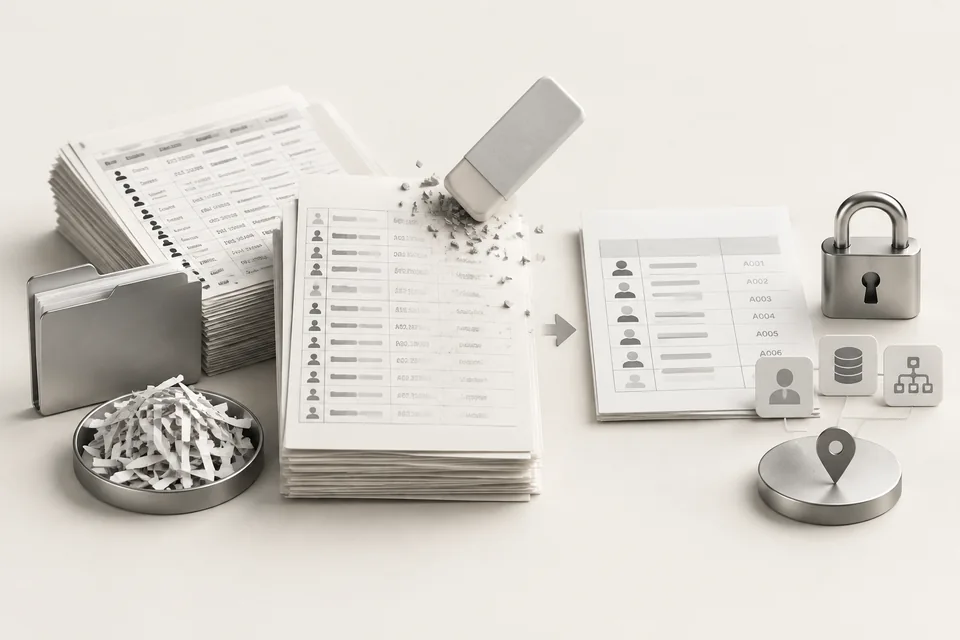
判断标准只有一条:这个字段,如果出现在一封误发的邮件里,你会不会紧张。会紧张的,上传前就应该删掉或者替换。任务本身几乎从不需要真实姓名、身份证号和手机号,它需要的是"同一个人的多条记录能对上",编号完全可以承担这个功能。
先给字段分三级,再动手
分级之后,删什么、换什么、留什么,一次就能定下来。
级别
典型字段
处理方式
必删
身份证号、银行卡号、密码、Session 凭据、Token
直接删除整列
替换
姓名、手机号、邮箱、详细地址、订单号
换成本地编号,映射表不外传
可留
商品名、品类、金额、日期、城市、状态
保留,注意组合识别
第三级容易被忽略。城市 + 出生日期 + 职位三项组合,在小范围内基本能定位到个人。处理时把出生日期改成年龄段,把职位改成职能类别,识别难度立刻上升。
替换编号怎么做才不会丢信息
核心原则是:编号本身不携带任何原始信息,映射关系只存在本地。
Excel 里的做法是新建一列 客户编号,用 C0001 这样的格式顺序编号,然后把姓名和手机号两列整体删除。删之前先另存一份原始文件放在本机加密盘里,文件名带上日期。
替代编号不能用身份证后四位、手机号后四位这类"半遮半掩"的方案。后四位在同一个城市的重合率相当高,配合其他两列就能反推。
更简单的一种做法是直接砍列。分析订单金额不需要客户姓名,做学习笔记不需要作者真名。每删掉一列,泄露面就少一块,同时模型的注意力也更集中。
文件名和元数据同样是内容
很多人删了正文里的姓名,却把文件命名成 张三_2026年体检报告.pdf。文件名会随文件一起进入对话。
上传前统一改名成 待分析_2026-10.pdf 这种纯任务描述。PDF 的文档属性里还有作者、创建者、创建时间,Word 的批注里可能有审阅人姓名。用"另存为"生成新文件,比在原文件上删更彻底。
还有一层:Excel 的隐藏工作表和隐藏列。肉眼看不到,解析时照样读得到。上传前统一取消隐藏,确认没有残留的工作表。
数据控制和"临时对话"分别管什么
这两件事经常被混为一谈。它们解决的是不同问题。
数据控制管的是模型训练。截至 2026 年 10 月 18 日核对,官方说明里的路径是 设置 → 数据控制 → Improve the model for everyone,关掉之后新对话不会用于训练模型。关掉训练不等于删除记录,已有对话仍然在历史里。
临时对话管的是历史与留存。官方写明的四条是:不出现在历史记录中、不创建或更新记忆、不用于改进模型、出于安全目的可能保留最多 30 天。开启位置是新建对话时选择 Temporary,然后选 Personalized 或 Unpersonalized。
临时对话还有一个细节:一旦你把它保存成普通对话,它就按普通对话的规则走,包括你账号的训练设置。所以"先临时后保存"不是安全的做法。
权限和数据控制不是一回事
这是最容易出错的地方。文件能不能被模型读到,和这份文件是不是敏感,是两个独立问题。
用 Google Drive、OneDrive 连接的文件,走的是你连接的那个账号的权限。官方说明里明确:使用连接的来源时,ChatGPT 使用所连接账号与应用权限,工作区管理员还可以控制哪些应用可用。
这意味着两件事:一是你能看到的工作区文件,接上之后模型也可能看到;二是共享盘里别人放的文件,权限没设好,你连上去就一并暴露了。
个人账号做分析时,我建议只上传本地导出的副本,不接云盘。少一层权限继承,就少一个想不清的边界。
存储与留存的实际数字
截至 2026 年 10 月 18 日核对,官方给出的几条:上传文件按用户计共享存储上限为 25 GB,企业工作区为 100 GB;删除对话不会删除已保存到 Library 的文件,要单独去 Library 删;删除后系统在 30 天内安排永久删除;企业工作区的临时文件在部分情况下 48 小时后过期。
这几个数字的作用是提醒:删除动作要分两处做。会话删了,Library 里还有一份。
Library 的位置在左侧边栏,点进去可以看到存储用量和剩余空间。批量清理时按文件类型筛选,一次勾选多个再删,比逐个点省事。
上传额度也是隐私决策的一部分
上传频率上限是每 3 小时 80 个文件,Free 账号每天 3 个。这个额度限制了"先大量上传再慢慢筛"的做法,反而促使人先做筛选。
我的习惯是建一个 脱敏_ 前缀的文件夹,所有要上传的文件先放进去,删完、改完名、检查完隐藏列,再一次性传。传完这个文件夹可以整个删掉。
什么情况下干脆不要上传
三类内容我建议不上传:一是含完整身份证号、银行卡号、密码的原始档案;二是别人的医疗记录、未成年人信息;三是公司明确列为机密且没有书面授权的材料。
这三类即使做了脱敏,风险仍然来自"上传"这个动作本身。替代方案是把需要的部分抄成一段文字,只发那一段。任务往往只需要 3 个字段,不需要整份 80 页的档案。
关于账号凭据这类更敏感的内容,账号与 CDK 的处理边界里写得更细。如果你打算用临时对话做一次性处理,临时对话的实际行为里列了它在历史、记忆、留存上分别怎么处理。清洗数据时如果还涉及原始 CSV 的结构问题,先定规则再清洗的流程可以对照着看。
截至 2026 年 10 月 18 日核对,数据控制菜单、临时对话规则与存储上限以 OpenAI 帮助中心《Data controls in ChatGPT》《Temporary chat in ChatGPT》《Uploading files and audio to ChatGPT》为准;这些设置可能随版本调整,以账号内实际显示为准。
参考资料资料核对日期:2026-10-17
• Data controls in ChatGPT | OpenAI Help Center
• Uploading files and audio to ChatGPT | OpenAI Help Center
• Temporary chat in ChatGPT | OpenAI Help Center
延伸阅读• CDK 充值时怎样保护账号?分清订单信息与登录凭据
• 用 AI 清洗 CSV,先定规则,再保留一份变更记录
• 临时聊天什么时候用?先选好个性化方式
• 用 ChatGPT 从图片提取文字:模糊的地方要留疑问